
先核实,再信任
每一页返回的不只是文本,还有质量信号。警告会点明具体风险——字形乱码、图像化文本、阅读顺序分歧——并以下一步该做什么收尾。
PDF 提取最糟糕的一点是:失败看起来和成功一样。扫描件返回空文本,损坏的字体映射返回看似可读的乱码,双栏论文返回时两栏交错——而它们都会作为一次正常、成功的结果返回。信任了它的智能体会给出错误答案,却始终不知道哪里出了问题。
这个领域的多数工具瞄准的是转换:把 PDF 变成干净的 Markdown,然后期待结果足够忠实。pdfvision 瞄准的是诊断——它标记出提取结果不可信的页面,并在那里取回局部的视觉证据。
它围绕的循环是:
这个循环更接近人类阅读 PDF 的方式:先浏览页面,注意视觉页面和提取文本何时不一致,再放大决定答案的那张图表或那个表单字段。
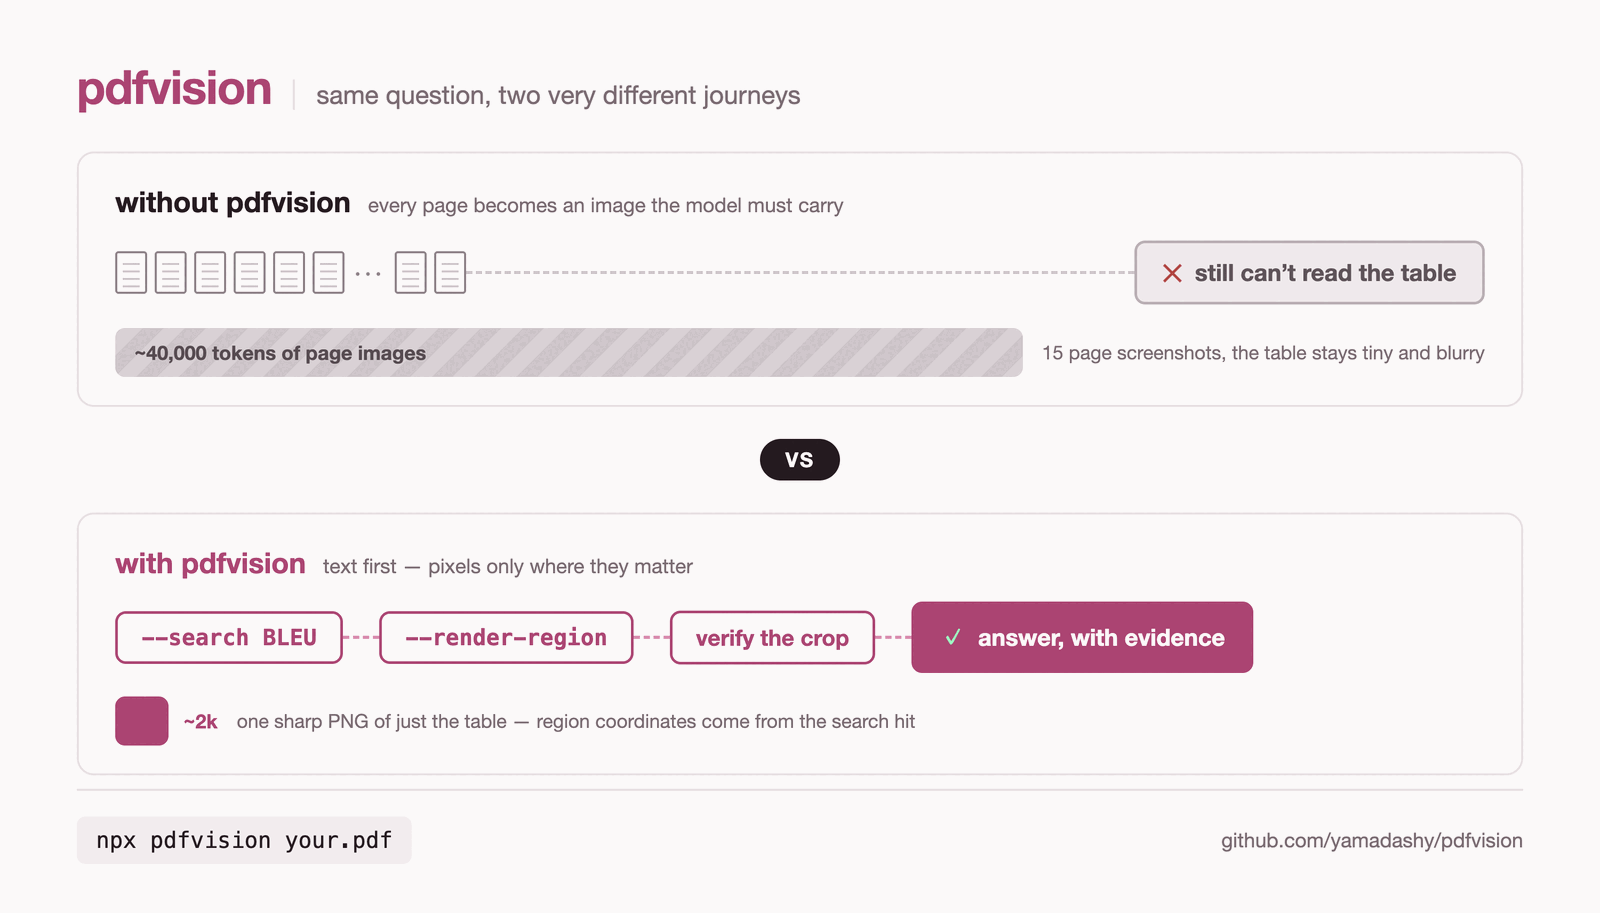
布局重建、OCR、visual region 等其余能力在指南中介绍。
无需安装即可运行:
npx pdfvision document.pdf提取出问题时,页面自己会说出来。下面的例子里,警告指出的是视觉顺序与原生文本顺序的分歧,而它引用的那几行还暴露出另一个问题——这份 PDF 的字体映射无法解码一张图的标签列:
$ npx pdfvision tracemonkey.pdf -p 10
_chars: 6944 · images: 0 · coverage: 42% · vectors: 17 · warnings: 1 · size: 612×792pt_
… page body …
### Warnings
> **warning** (reading_order_divergence): layout line "?>9@AJ.0A:</C./8-2#3$4%56#" appears
> after "?>9@AJ.D<F@-<>2.@A:0>#3$4,56#" visually but earlier in the native text stream —
> native line order diverges from what a human reads; the body above is that reading order,
> rebuilt from the layout — render the page when exact sequence is critical
如果没有这条警告,智能体只会把 ?>9@AJ.0A:</C./8-2#3$4%56# 当作一次成功的提取来读,并且永远不会发现问题。
为多模态模型渲染页面图像:
npx pdfvision document.pdf --render从 URL 提取结构化 JSON:
npx pdfvision --remote https://raw.githubusercontent.com/mozilla/pdf.js-sample-files/master/tracemonkey.pdf --format json搜索证据,然后只裁剪匹配区域:
npx pdfvision report.pdf --search "revenue" --json
npx pdfvision report.pdf --pages 3 --render --render-region 120,180,360,140 --render-output ./crops --json
不渲染每一整页,也可以检查视觉结构:
npx pdfvision slides.pdf --layout --image-boxes --vector-boxes --visual-regions --json
npx pdfvision slides.pdf --render-visual-regions --render-output ./regions --json